

French
Un rétrécissement coronarien peut apparaître différemment selon l’angle de la caméra à rayons X. Les cardiologues examinent donc plusieurs projections avant de déterminer la localisation d’une lésion et d’en estimer la sévérité. Les premiers modèles d’IA appliqués à l’angiographie analysaient généralement des images ou des vidéos isolées, sans exploiter l’information du reste de l’examen.
DeepCORO-CLIP apprend à partir des vidéos d’angiographie et des comptes rendus qui les décrivent, puis combine plusieurs vues pour analyser un examen. Publiée dans Nature Cardiovascular Research, l’étude évalue cette approche pour mesurer les sténoses et caractériser les lésions. Elle examine aussi si la représentation apprise peut servir à estimer la fonction cardiaque et à prédire de futurs événements cardiovasculaires.
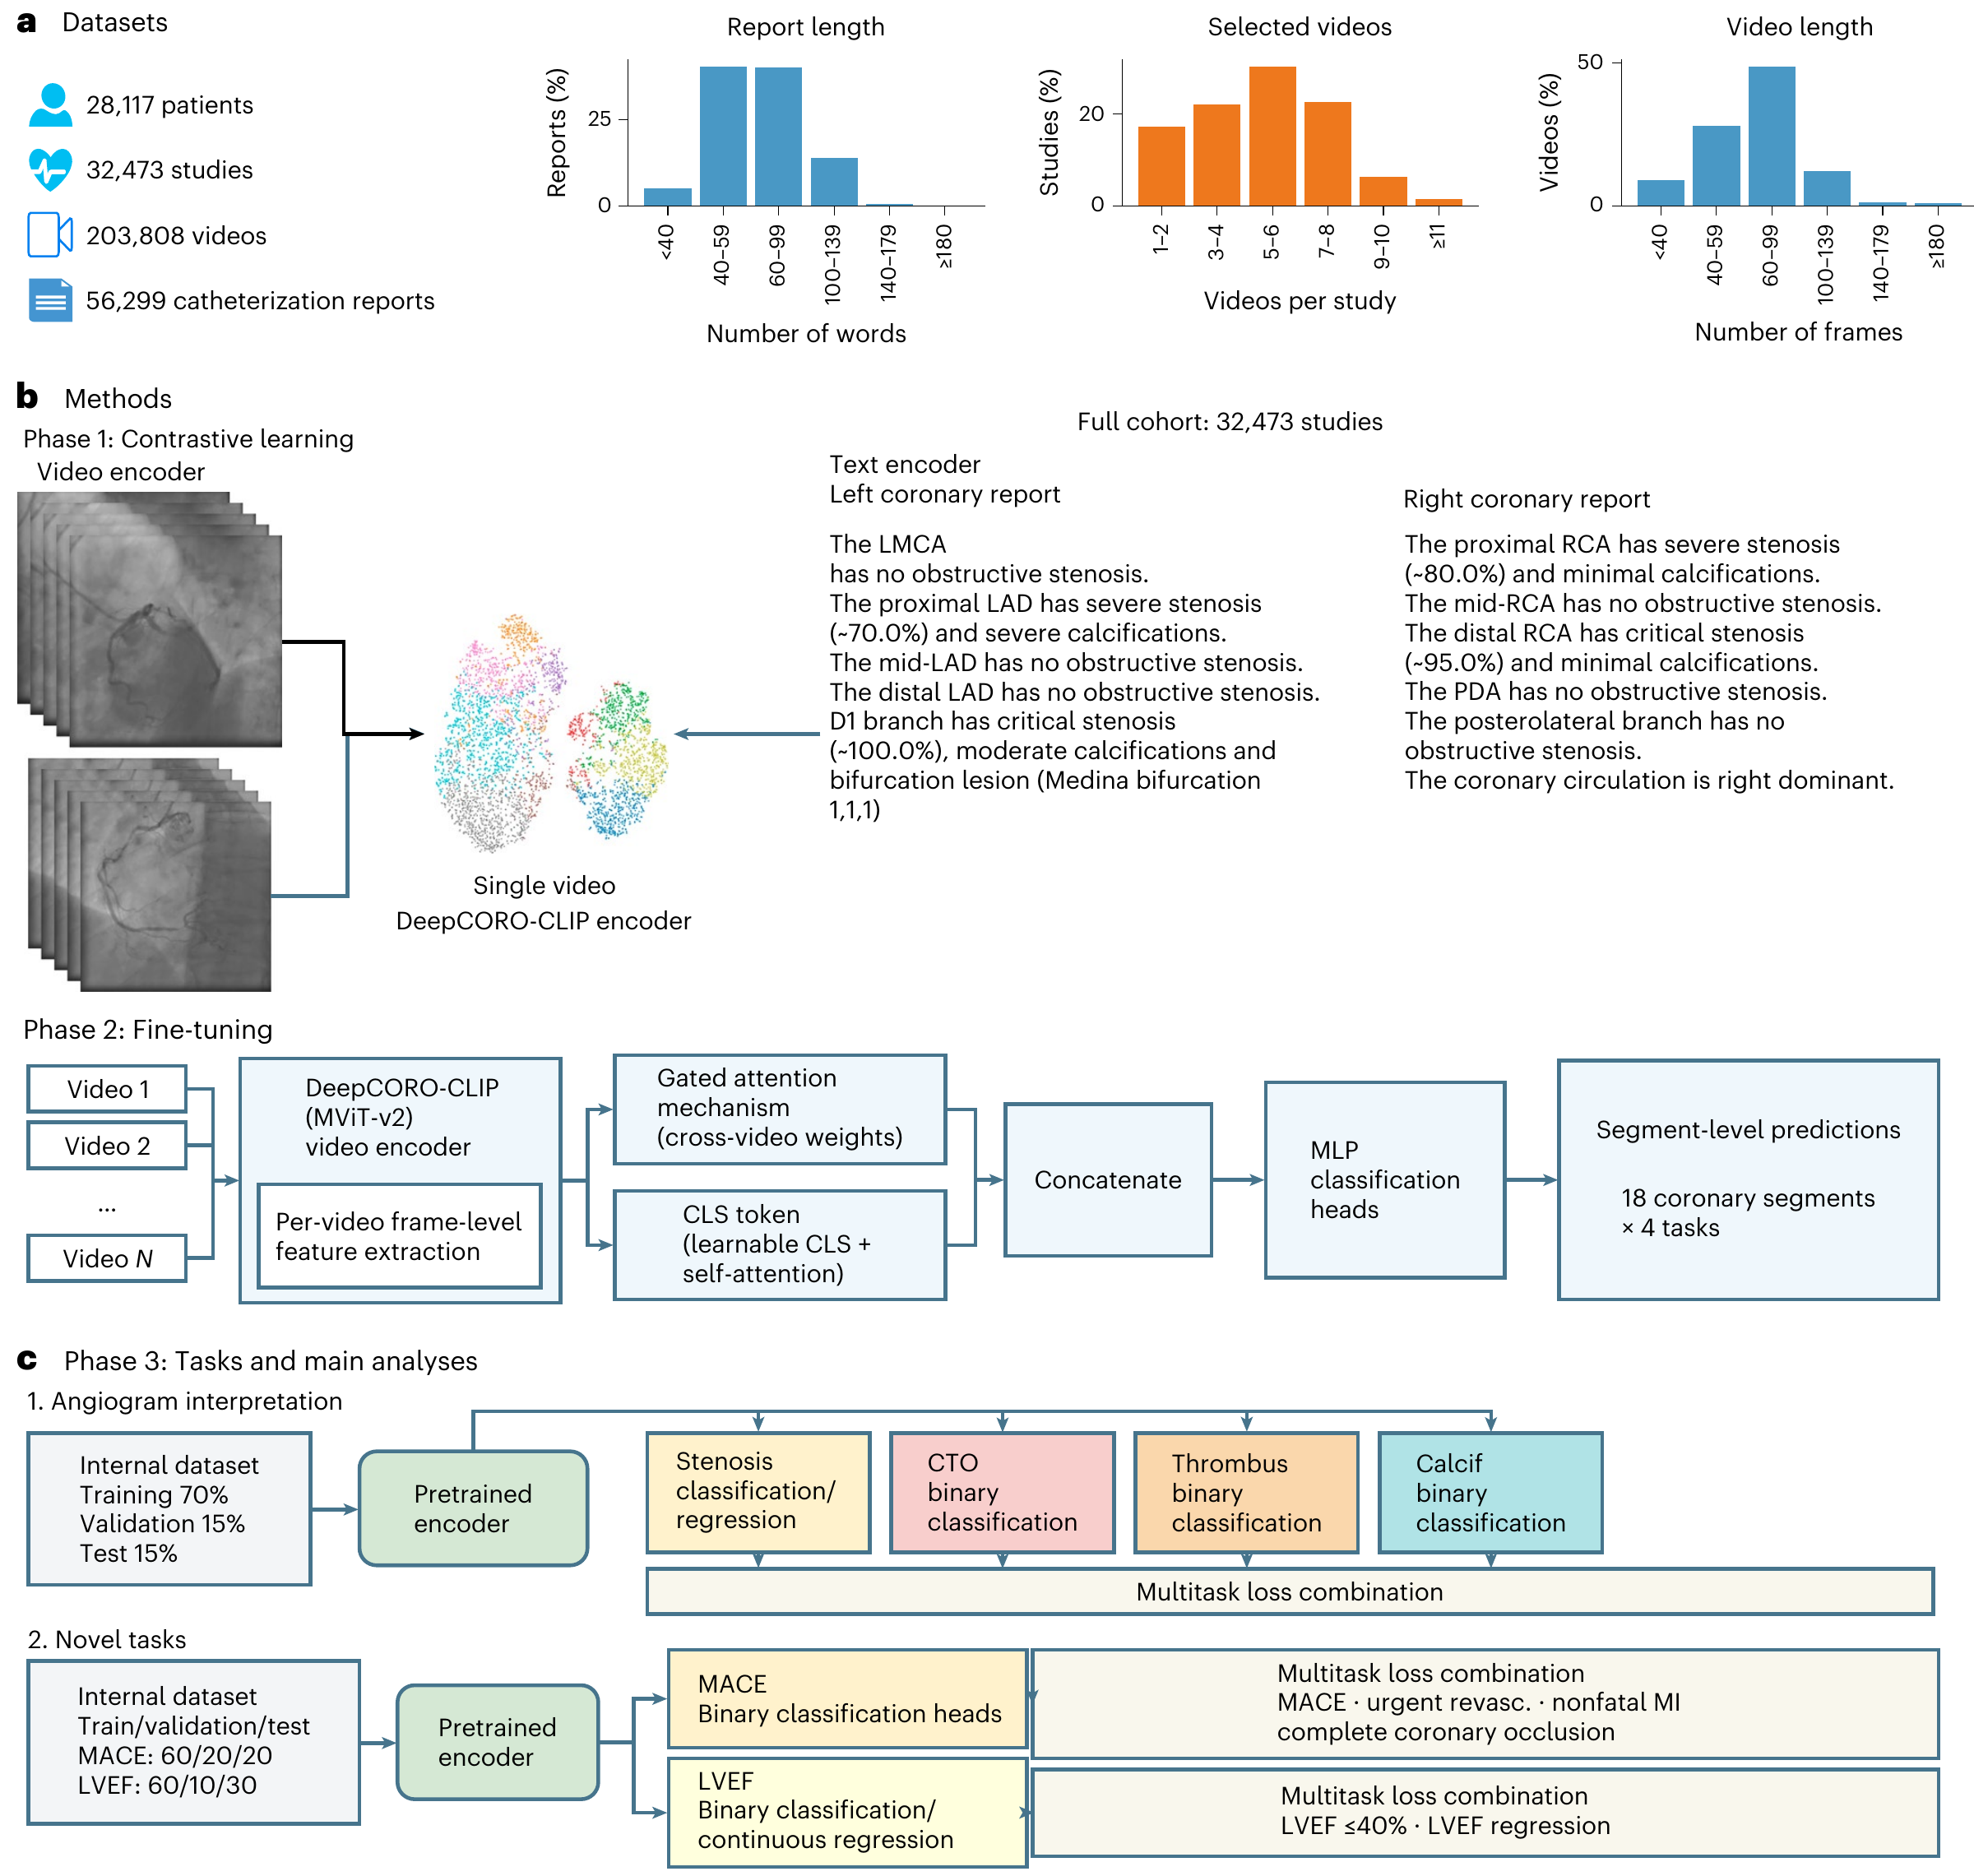
La cohorte de développement comprenait 203 808 vidéos provenant de 32 473 examens réalisés chez 28 117 patients à l’Institut de Cardiologie de Montréal, associées à 56 299 comptes rendus de cathétérisme. Les ensembles d’entraînement, de validation et de test ne partageaient aucun patient. Les acquisitions diagnostiques ont été sélectionnées avant l’intervention : le modèle apprenait ainsi à partir des artères avant que l’angioplastie n’en modifie l’apparence. Les patients ayant déjà subi un pontage coronarien ont été exclus.
L’entraînement s’est déroulé en deux étapes. Un apprentissage contrastif a d’abord aligné la représentation de chaque vidéo avec le texte du compte rendu correspondant. L’encodeur apprenait ainsi à associer les caractéristiques visuelles aux descriptions de l’anatomie et des lésions coronariennes. Il a ensuite été ajusté pour regrouper l’information des différentes vidéos par un mécanisme d’attention et produire des prédictions pour 18 segments coronariens.
Le modèle diagnostique estime la sévérité des sténoses et identifie les lésions obstructives, les occlusions totales chroniques, les thrombus intracoronariens et les calcifications. Dans des expériences distinctes, l’encodeur préentraîné a été adapté à l’estimation de la fraction d’éjection ventriculaire gauche (FEVG) et à la prédiction d’événements cardiovasculaires.
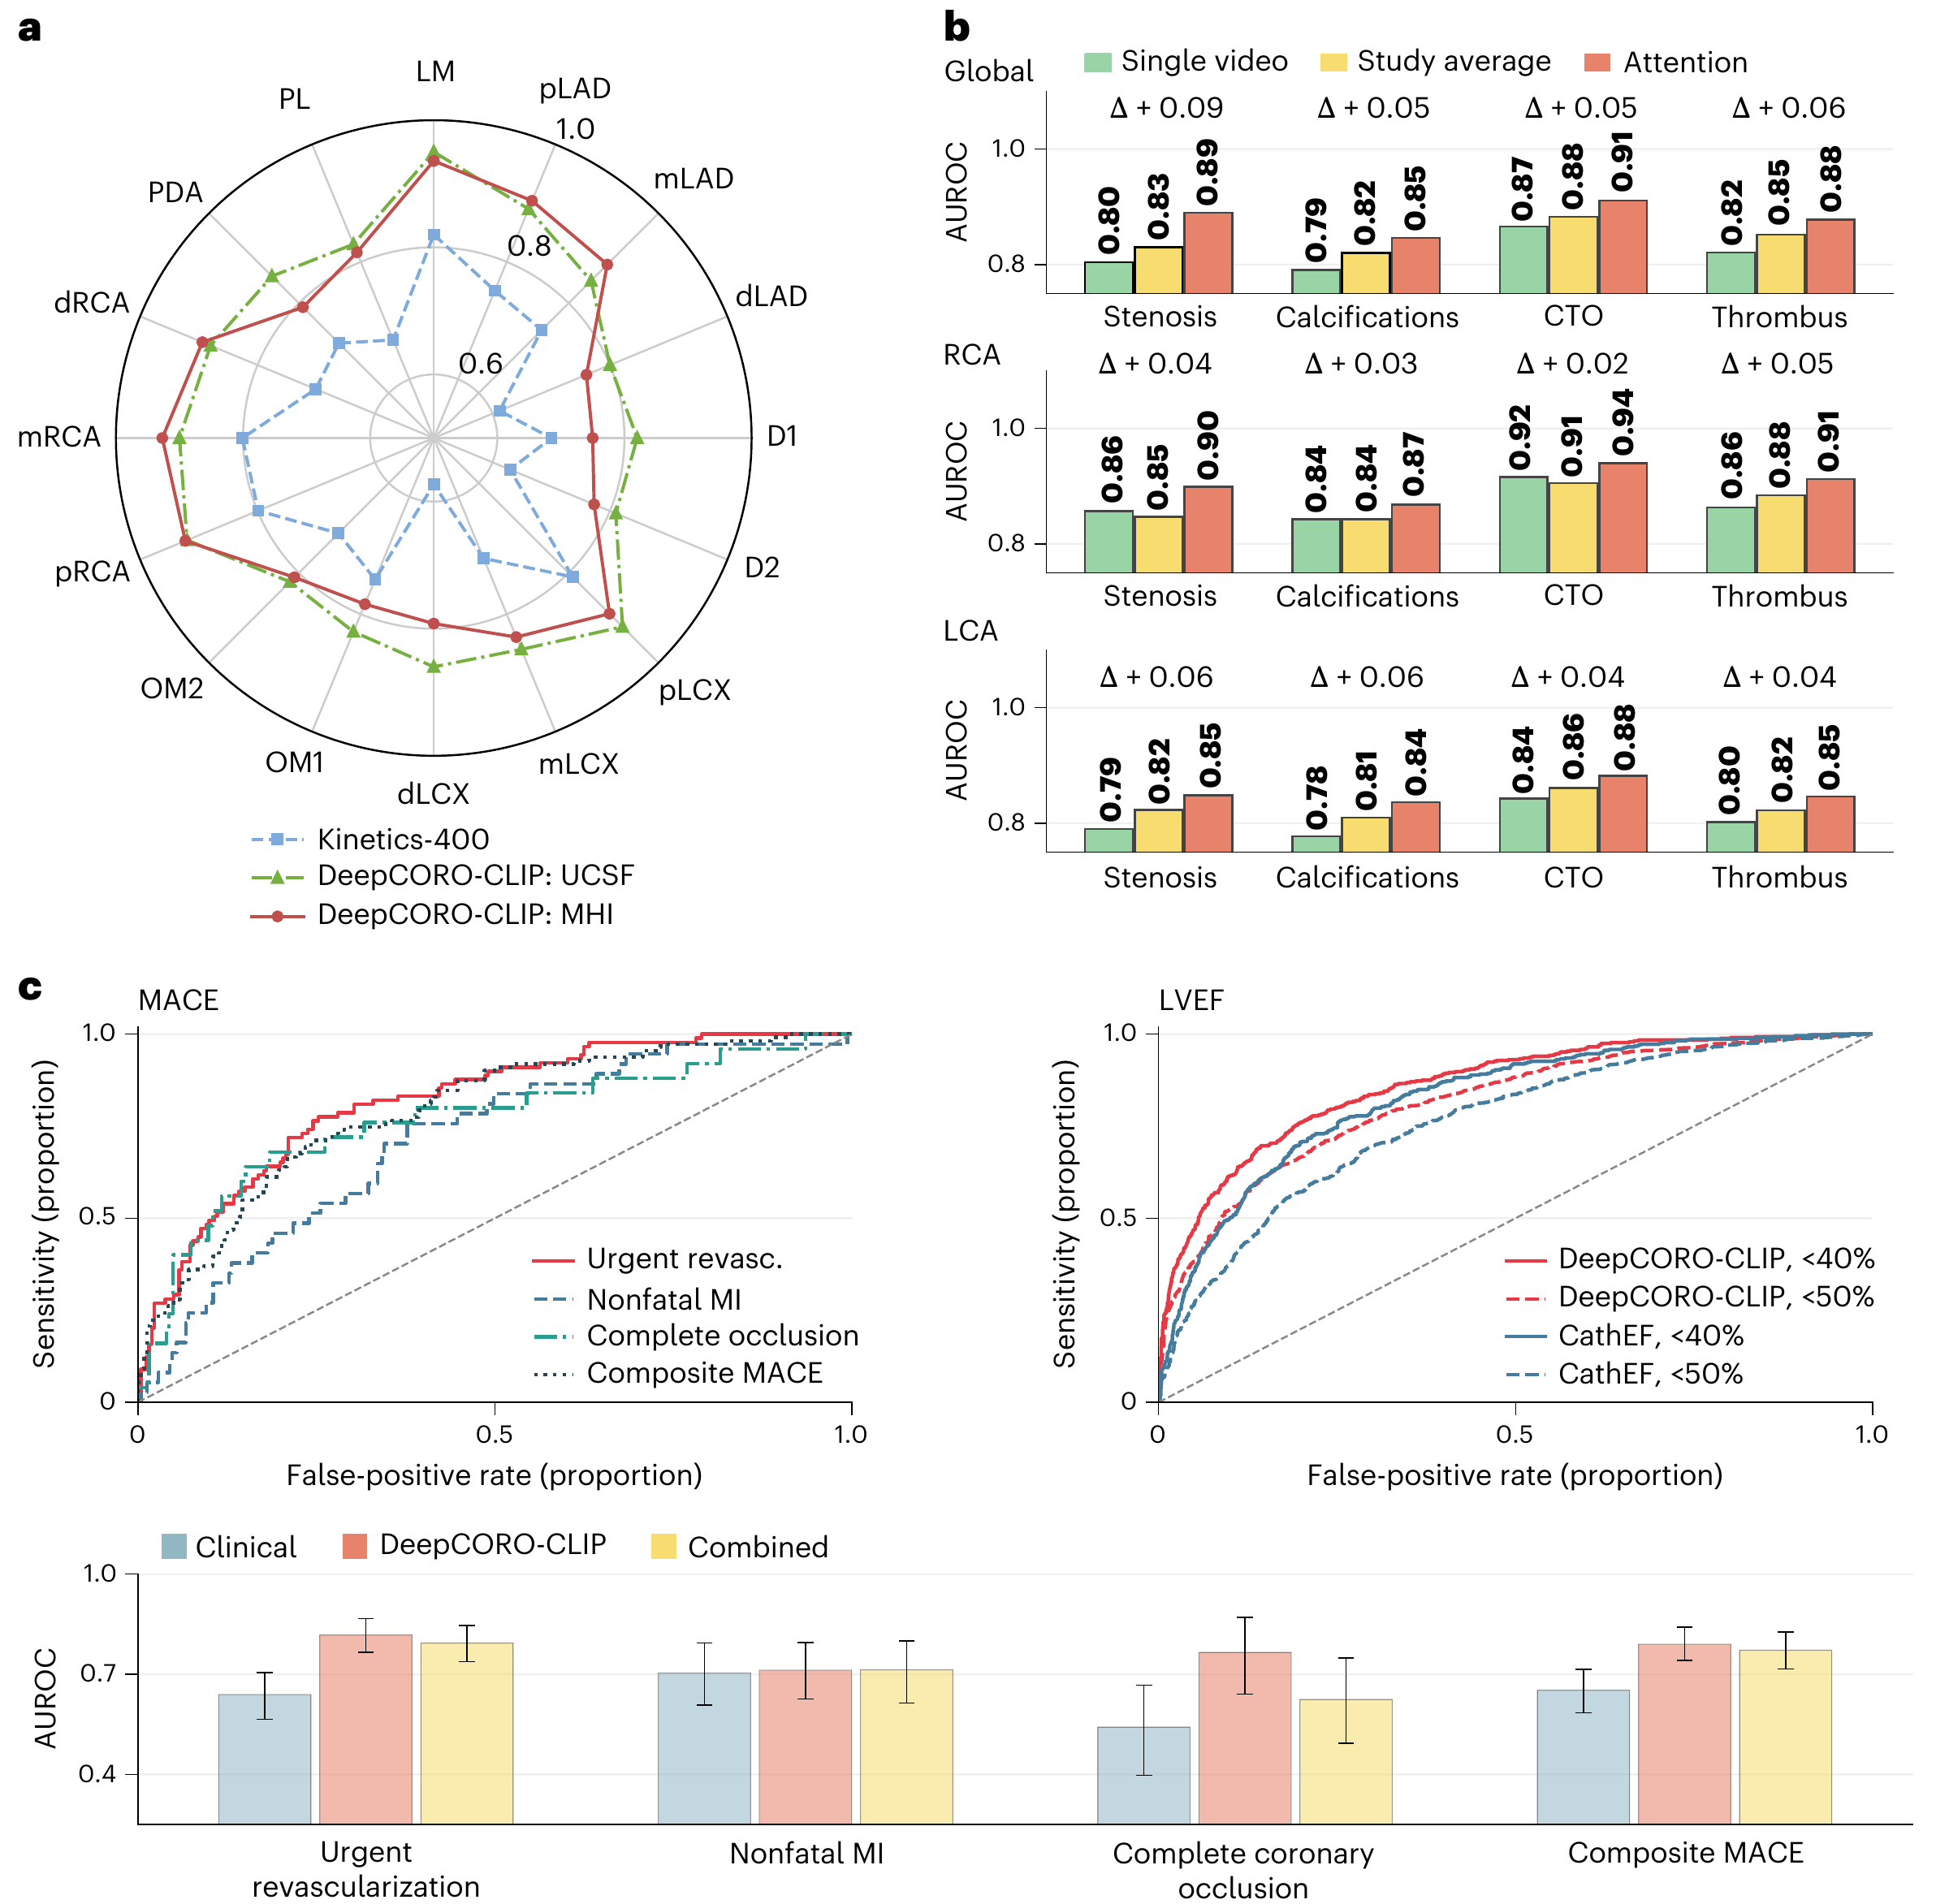
Dans l’ensemble de test interne de 4 828 examens, DeepCORO-CLIP détectait les sténoses obstructives avec une AUROC globale de 0,89 (IC à 95 % : 0,88–0,89). Au seuil défini par l’indice de Youden, la sensibilité était de 0,85 (IC à 95 % : 0,84–0,86) et la spécificité de 0,70 (IC à 95 % : 0,70–0,71). L’étude définissait une sténose obstructive comme une réduction du diamètre d’au moins 70 %, ou de 50 % pour le tronc commun de l’artère coronaire gauche.
Le modèle estimait également le pourcentage de rétrécissement et d’autres caractéristiques des lésions. Tous les résultats ci-dessous proviennent de l’ensemble de test interne. Les valeurs entre parenthèses sont les intervalles de confiance à 95 %.
Le regroupement des vues par attention améliorait la discrimination par rapport à l’utilisation d’une seule vidéo ou à la moyenne des prédictions vidéo. Le préentraînement vidéo–texte améliorait également les performances par rapport à un encodeur préentraîné sur des vidéos généralistes. Ces comparaisons soutiennent l’intérêt d’apprendre à la fois des comptes rendus cliniques et des différentes projections d’une coronarographie.
DeepCORO-CLIP a été évalué sur 4 249 examens de l’Université de Californie à San Francisco. La discrimination des sténoses obstructives se maintenait, avec une AUROC de 0,89 (IC à 95 % : 0,88–0,89). L’estimation du degré de sténose était moins précise en validation externe : l’erreur absolue moyenne était de 12,1 points de pourcentage (IC à 95 % : 11,9–12,3), contre 9,2 (IC à 95 % : 9,1–9,4) en interne. Cette distinction est importante : la détection des lésions obstructives se transposait mieux à un autre centre que l’estimation de leur sévérité exacte.
Les chercheurs ont aussi comparé les prédictions à des mesures de coronarographie quantitative réalisées par un laboratoire central indépendant, plutôt que de s’appuyer uniquement sur les comptes rendus cliniques initiaux. Deux cardiologues interventionnels ont examiné 662 examens contenant 965 lésions ; un troisième lecteur tranchait les désaccords importants.
Par rapport à ces mesures arbitrées, l’erreur absolue moyenne de DeepCORO-CLIP était de 13,6 points de pourcentage (IC à 95 % : 12,5–15,2), contre 19,0 (IC à 95 % : 17,6–20,5) pour les comptes rendus cliniques initiaux. La corrélation du modèle avec les mesures arbitrées était de 0,64 (IC à 95 % : 0,58–0,70). Il s’agissait d’une évaluation distincte, utilisant un autre étalon de référence que l’analyse principale de l’ensemble de test.
L’encodeur préentraîné a été adapté à l’estimation de la FEVG à partir de vidéos de coronarographie associées à des échocardiogrammes réalisés dans un intervalle de 30 jours. L’ensemble de test réservé comprenait 2 530 examens.
DeepCORO-CLIP réduisait l’erreur d’estimation par rapport à CathEF, un modèle antérieur conçu pour cette tâche. Les valeurs entre parenthèses sont les intervalles de confiance à 95 %.
Ces estimations provenaient des vidéos de coronarographie elles-mêmes. L’échocardiographie fournissait les mesures de référence pour l’entraînement et l’évaluation ; elle n’était pas une donnée d’entrée du modèle au moment de l’inférence.
Dans une expérience distincte, l’encodeur a été ajusté pour prédire les événements cardiovasculaires indésirables majeurs (MACE) à partir de la coronarographie diagnostique. Le critère composite regroupait la revascularisation urgente, l’infarctus du myocarde non fatal et l’occlusion coronarienne complète survenant après la première semaine et dans l’année suivant l’examen.
L’ensemble de test réservé comprenait 350 patients, dont 111 avaient présenté un événement du critère composite. Le modèle utilisait les vidéos d’angiographie sans données démographiques, mesures biologiques ni facteurs de risque cliniques en entrée. Les AUROC et leurs intervalles de confiance à 95 % étaient les suivants :
La discrimination du critère composite était supérieure à celle d’un modèle de référence fondé sur les variables cliniques, évalué dans la même cohorte. L’ajout de ces variables au score du modèle n’améliorait pas la discrimination. Ces premiers résultats proviennent d’une cohorte relativement petite. Le suivi était souvent inférieur à un an et les patients sans suivi documenté étaient exclus. L’étude ne permet donc pas d’établir une estimation du risque à un an pleinement validée pour l’ensemble des patients soumis à une coronarographie.
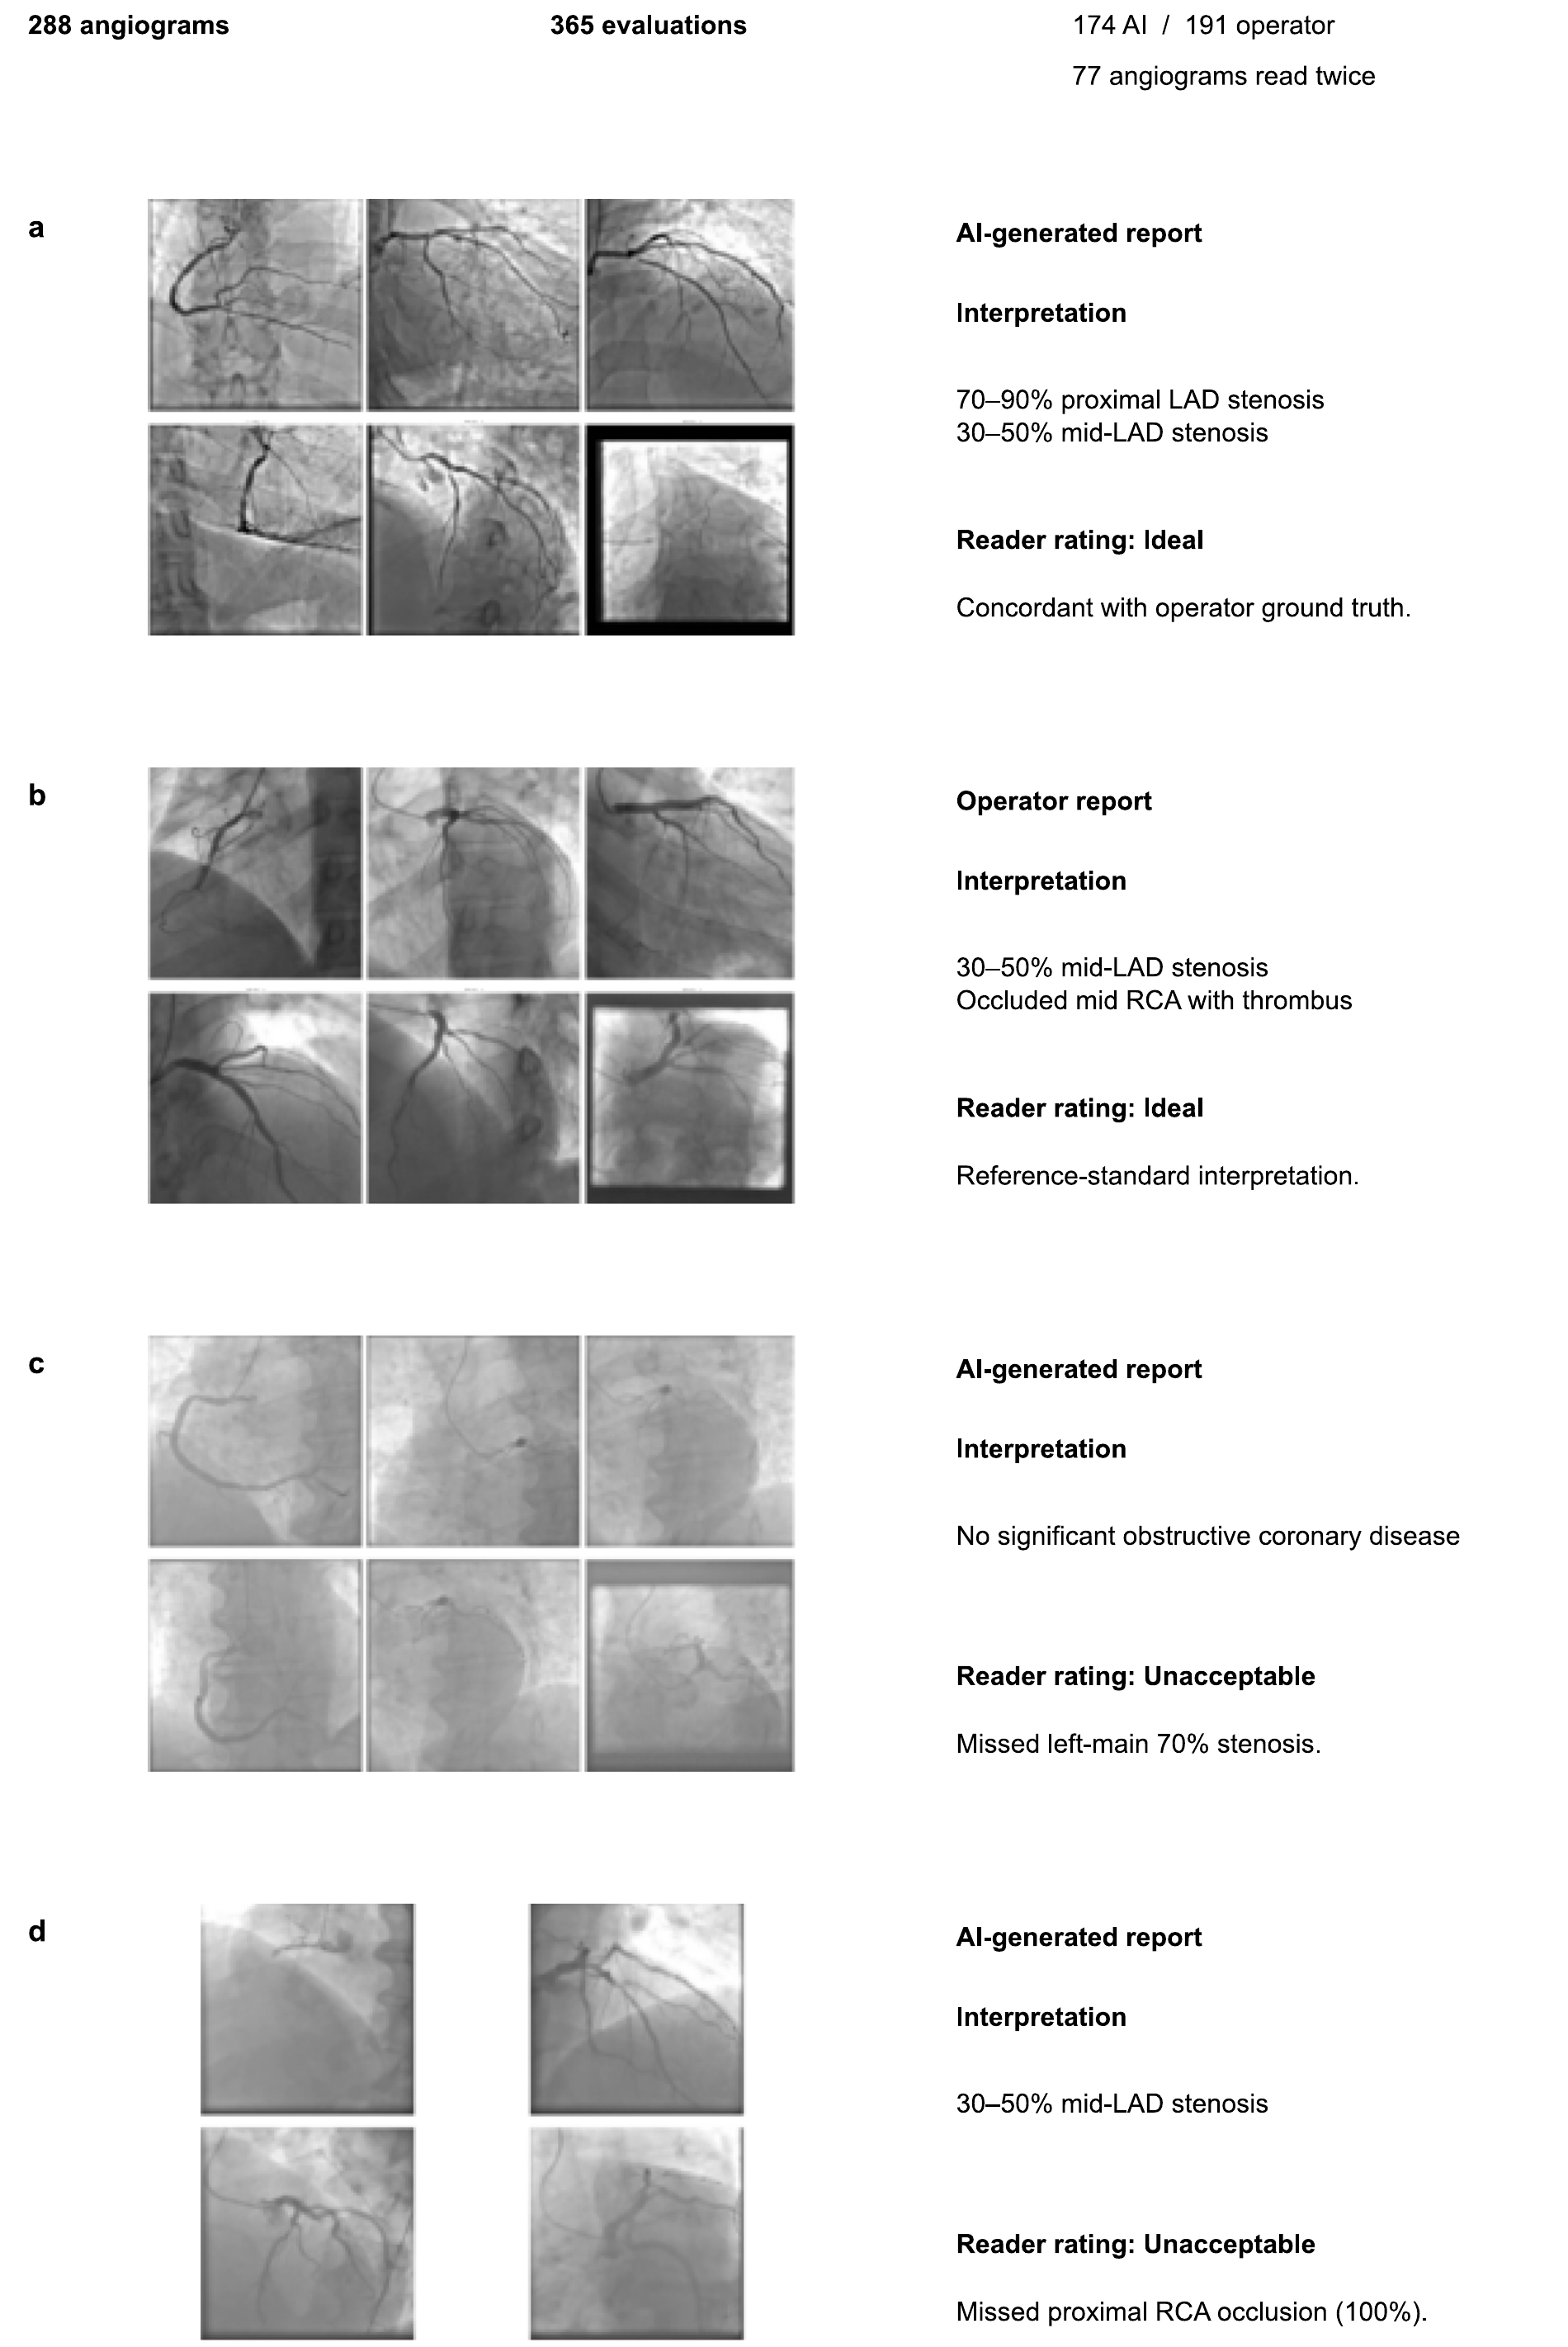
L’étude examinait également la qualité des comptes rendus produits à partir des prédictions du modèle. Ces textes étaient générés à l’aide d’un gabarit décrivant la sévérité des sténoses et les caractéristiques des lésions par segment coronarien. Il ne s’agissait pas de réponses libres d’un modèle de langage.
Deux cardiologues interventionnels ont évalué 365 comptes rendus portant sur 288 coronarographies, sans savoir si chaque texte provenait de DeepCORO-CLIP ou du cardiologue ayant réalisé l’examen. Les deux sources étaient présentées dans le même format afin que la formulation ne révèle pas leur origine.
Les comptes rendus de DeepCORO-CLIP ont été jugés utilisables en clinique dans 75,9 % des évaluations (132/174 ; IC à 95 % : 69,0–81,6 %), contre 88,5 % pour ceux des opérateurs (169/191 ; IC à 95 % : 83,2–92,3 %). L’article rapportait des chances d’utilisabilité plus faibles pour les comptes rendus du modèle : rapport de cotes de 0,41 (IC à 95 % : 0,23–0,72).
La principale limite était l’omission de lésions, en particulier de sténoses obstructives proximales. Des constatations hallucinées ont été signalées dans 17,2 % des évaluations des comptes rendus du modèle (30/174 ; IC à 95 % : 12,4–23,5 %) et dans 13,6 % de celles des comptes rendus des opérateurs (26/191 ; IC à 95 % : 9,5–19,2 %). Le rapport de cotes correspondant était de 1,32 (IC à 95 % : 0,75–2,34), sans différence statistiquement significative détectée.
Les intervalles de confiance des pourcentages de cette section sont des intervalles de Wilson calculés à partir des effectifs d’évaluation publiés. Les rapports de cotes et leurs intervalles de confiance proviennent de l’article. Certaines coronarographies ayant été évaluées par les deux lecteurs, ces pourcentages décrivent des évaluations de comptes rendus, et non des résultats cliniques indépendants par patient.
La chaîne de génération des comptes rendus utilisait un seuil de probabilité de 0,50 pour signaler une anomalie dans un segment. Ce choix favorisait la précision, mais laissait certaines lésions obstructives non signalées. Des seuils plus bas permettaient de retrouver davantage de lésions, au prix de plus de faux positifs.
La chaîne publiée permet de configurer les seuils par segment coronarien. Toutefois, les seuils alternatifs présentés dans l’article ont été choisis et évalués sur le même ensemble de test. Leurs gains apparents doivent donc être confirmés sur de nouveaux patients, avec des seuils définis à l’avance. L’étude de lecture justifie de poursuivre l’évaluation du système comme aide à la rédaction, sous supervision clinique.
DeepCORO-CLIP a été intégré à PACS-AI, qui reçoit les examens d’angiographie, prépare les vidéos, exécute l’inférence et rend l’analyse accessible dans le visualiseur PACS. Lors de l’expérience de déploiement, ce processus s’effectuait en quelques secondes, prétraitement et génération du compte rendu à partir du gabarit compris.
Cette intégration permet aux cliniciens de consulter les résultats à côté des images originales. L’étude n’établissait pas si l’utilisation du système modifie les décisions thérapeutiques ou améliore les résultats pour les patients. Ces questions nécessitent une évaluation prospective en pratique clinique.
Les performances étaient meilleures dans les gros vaisseaux proximaux. Les lésions distales et celles des branches secondaires restaient plus difficiles à évaluer ; les estimations dans ces segments demandent donc une attention particulière. Les patients ayant subi un pontage coronarien étaient exclus, et la validation externe se limitait à un établissement supplémentaire. Les résultats concernant la FEVG et la prédiction d’événements doivent également être validés hors du centre de développement.
DeepCORO-CLIP propose une manière d’apprendre à partir des vidéos et des comptes rendus de coronarographie de routine, de combiner les vues d’un examen et d’adapter l’encodeur obtenu à plusieurs tâches cliniques. Le code et les poids du modèle publiés permettent à d’autres équipes de tester l’approche sur leurs propres données et d’examiner dans quels contextes elle se transpose bien, et où elle nécessite encore du travail.
L’article met les poids à disposition sous licence Apache 2.0 et le code à disposition pour la recherche non commerciale, selon l’accord d’utilisation à des fins de recherche de l’ICM. Les conditions d’accès propres à chaque modèle sont précisées sur Hugging Face. Les données des patients ne sont pas rendues publiques pour des raisons de confidentialité.